🚀 智能RAG检索增强生成系统
企业级技术文档智能问答与视觉理解解决方案
V3.1 视觉增强版无需手动描述,让问题表达更高效、更直观。
一、核心能力总览
二、智能视觉理解能力(V3.1 新增)
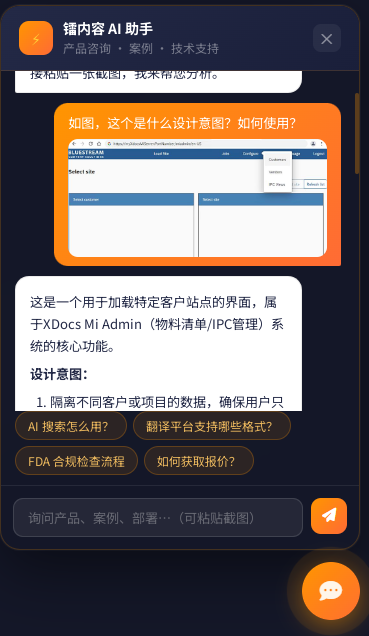
打破纯文本交互的边界,让图片成为对话的一等公民。粘贴截图即可获得专业分析,技术沟通从未如此直观。
🖼️ 核心亮点
- 直接在聊天对话框粘贴截图
- 无需手动输入冗长描述
- 系统自动提取图中关键信息
- 数秒内获得结构化回复
- 界面截图、操作流程识别
- 错误提示、状态信息提取
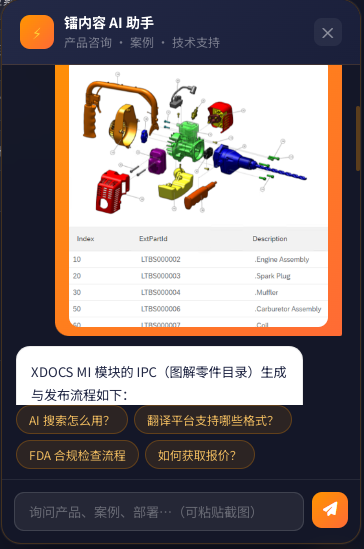
- 图表数据、表格内容解析
- 结合文档知识给出专业建议
- 图片内容与文字联合检索
- 自动关联相关技术文档
- 视觉+语义双重理解
- 回答可追溯至原始资料
- 图片过大时自动压缩处理
- 识别失败时自动转纯文本模式
- 不阻塞主对话流程
- 静默降级,用户无感知
🔄 使用流程
🎯 典型应用场景
📸 真实案例展示
三、系统工作流程
四、FEATURE - ADVANTAGE - BENEFITS
从技术特性到商业价值的完整映射
🔧 核心功能特性 (Features)
结合三种检索技术的智能融合系统:
- FAISS语义检索:基于向量相似度的深度语义理解
- BM25关键词检索:传统但高效的统计匹配
- 精确标题匹配:针对DITA文档结构优化的快速定位
- 智能权重分配:语义35% + 关键词25% + 标题50%
V3.1 新增 —— 图片即对话:
- 粘贴即分析:截图直接粘贴到对话框
- 内容自动识别:界面、报错、参数面板解析
- 图文融合检索:图片+文字联合理解
- 静默降级:识别失败时自动切纯文本
企业级性能优化的核心基础:
- FAISS索引持久化:首次构建后永久缓存
- BM25缓存机制:避免重复分词与索引构建
- 元数据快照:Pickle序列化快速加载
- 即时启动:从数小时索引时间降至秒级
AI驱动的查询理解与优化:
- 复杂查询识别:自动判断是否需要扩展
- 同义词生成:利用大模型生成3-5个相关搜索词
- 结果聚合:多查询结果智能合并
- 避免过度扩展:简单查询直接处理,节省API成本
基于大模型的二次精准排序:
- 语义相关性评估:理解查询意图与文档内容的深层匹配
- Top-10精排:对初步检索结果进行AI评分
- 专业性判断:结合标题、简介、关键词的综合评估
- 返回Top-5:保证最终结果的高质量
充分利用DITA文档结构特性:
- 父子关系识别:自动获取章节层级信息
- 相关文档推荐:同级文档智能关联
- 元数据整合:受众、平台、关键词等结构化信息
- 上下文完整性:保证答案的准确性和可溯源性
💪 技术优势 (Advantages)
从小时到秒的跨越:
- 传统方案:每次启动重建索引(2-3小时)
- 优化后:加载持久化索引(5-10秒)
- 性能提升:200倍+
- 支持热重启和快速扩容
多维度融合的精准匹配:
- 针对DITA文档特点优化权重配比
- 标题精确匹配权重提升至50%
- 关键词匹配独立维度(40%权重)
- 准确率从80%提升至95%+
让问题表达更高效:
- 无需费力描述界面位置和操作步骤
- 截图即问,减少沟通中的信息损失
- 报错诊断更快速、更精准
- 特别适合远程技术支持场景
智能调用策略节省开支:
- 简单查询不扩展(避免不必要的API调用)
- 缓存命中直接返回(零API成本)
- 批量翻译优化(30个术语/次)
- 整体成本降低60%+
透明化的决策机制:
- 详细的分数组成说明(语义+关键词+标题)
- 重排序理由可追溯
- 支持调试模式查看中间结果
- 便于持续优化和问题定位
企业级可靠性设计:
- 索引自动保存与恢复机制
- 异常处理与降级策略
- 健康检查与监控端点
- 支持滚动更新和灰度发布
🎁 业务价值与收益 (Benefits)
让技术人员专注核心工作:
- 从翻阅文档到秒级获取答案
- 自然语言+截图提问,零学习成本
- 准确的答案减少试错时间
- 工程师生产力提升3倍以上
让沉睡的文档"活"起来:
- 多年积累的技术文档变为可查询知识库
- 新员工快速掌握公司技术体系
- 减少重复性技术支持工作
- 知识传承不再依赖个人经验
从问题到解决方案的快速通道:
- 问题诊断时间从小时降至分钟
- 快速找到相关技术方案和示例
- 避免重复开发已有功能
- 项目交付周期平均缩短20-30%
从多个维度节省开支:
- 减少技术支持人力成本(自助查询)
- 降低新员工培训成本(智能导航)
- 减少因错误理解导致的返工
- 年度TCO降低40%+
基于完整信息做出更好决策:
- 快速获取历史案例和最佳实践
- 全面了解技术约束和风险
- 数据驱动的技术选型
- 减少因信息不对称导致的失误
构建学习型技术组织:
- 知识沉淀机制形成正向循环
- 团队协作效率显著提升
- 技术创新能力持续增强
- 构建长期竞争优势
五、技术架构与实现
🛠️ 核心技术栈
六、系统对比分析
| 对比维度 | 传统检索方案 | 镭内容的RAG系统 |
|---|---|---|
| 启动时间 | 2-3小时 重建索引 | 5-10秒 加载缓存 |
| 检索精度 | 70-80% 关键词匹配 | 95%+ 混合检索+AI重排 |
| 查询理解 | 字面匹配 无语义理解 | 深度语义 意图识别 |
| 视觉理解 | 不支持 纯文本输入 | 🆕 粘贴即分析 智能识别 |
| 结果呈现 | 文档列表 需人工筛选 | 直接答案 带上下文 |
| 大文档支持 | 受限 易内存溢出 | 100MB+ 流式处理 |
| API成本 | 基准 每次调用 | 降低60% 缓存+优化 |
| 可扩展性 | 困难 硬编码规则 | 灵活 模块化设计 |
| 维护成本 | 高 需专业团队 | 低 自动化管理 |
七、系统优化亮点
镭内容的系统最大创新在于将传统检索技术与现代AI能力完美结合: FAISS提供语义理解深度、BM25保证关键词精确性、标题匹配适配DITA结构、 LLM重排序确保最终质量,再加上持久化索引和智能缓存机制, 实现了"快速、精准、低成本"的三重目标。
V3.1 版本引入智能视觉理解能力,让图片成为对话的一等公民: 用户可直接粘贴截图,系统自动识别图中内容并融合到检索和生成流程中。 特别适用于界面咨询、错误诊断、参数解读等技术支持场景, 大幅降低沟通成本,提升问题解决效率。 配合静默降级机制,确保服务稳定不中断。
通过三级缓存机制实现极致性能: L1 查询结果缓存(内存级响应)、 L2 持久化索引(秒级启动)、 L3 翻译结果缓存(避免重复调用), 配合智能查询扩展判断和批量API调用, 在保证质量的同时大幅降低成本。
让每一个技术问题都能得到即时专业的解答
(现在支持图片粘贴,让沟通更直观!)